GPT-6.2不说人话,干活偷懒?官方连夜更新两份文档,我拆出 3 条避坑心法
昨天,OpenAI 正式放出 GPT-6.2——旗舰版 Astra 和轻量日常版 Sol。官方指标详见拙文《GPT-6.2 实测篇:Astra 科研 3D 杀疯了,日常写作却翻车》
新模型一上线,这两天大家都冲上去尝鲜,结果普通用户吐槽它"不说人话",开发者则反映编程容易卡顿。
这个卡顿,笔者亲身踩了:用 Codex 调 GPT-6.2 Sol 修一个故障,它分析出 6 个 bug,我点"执行",它一次只改 1 个就停住;我说继续完善,它又改 1 个,还剩 1 个。气得吐血。最后换回 6.1,一次搞定。
网上转一圈,类似困惑的用户不在少数。
亡羊补牢,OpenAI 官方今天更新了两份核心文档:《Using GPT-6.2(API 迁移指南)》和《Prompting GPT-6.2 in Codex(Codex 实战指南)》。
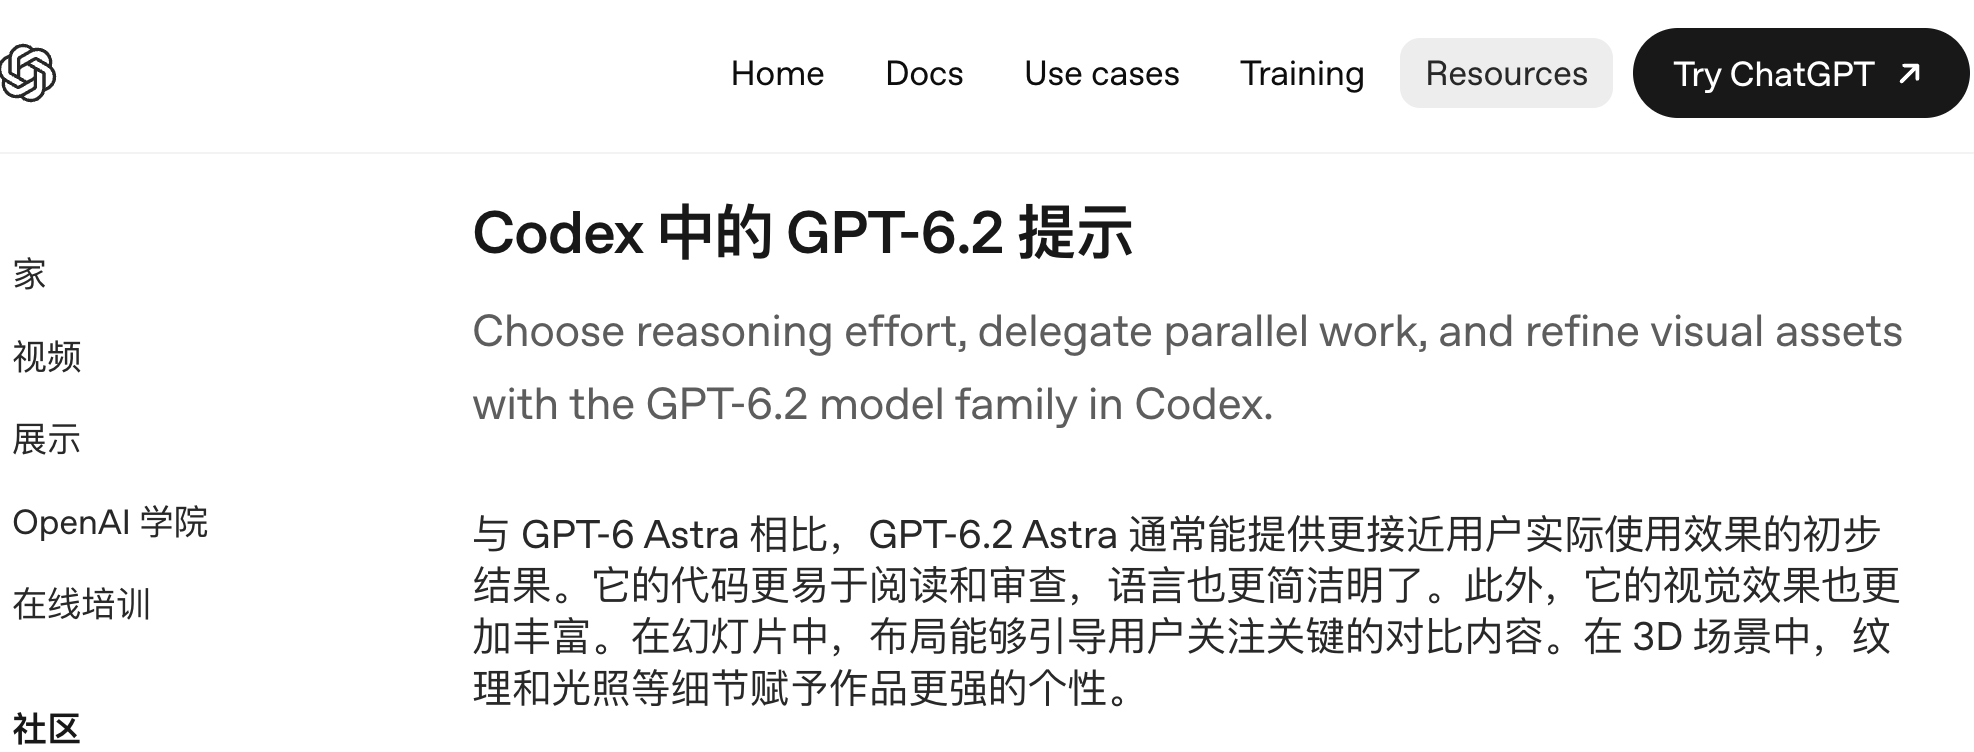
看完才恍然大悟:不是模型变懒了,是底层交互逻辑变了。我们还在用老一代的"保姆式"指令指挥它,自然水土不服。
我从两份官方指南里拆出 3 条真正能用的避坑心法。看完你就能判断:手里的提示词和 AGENTS.md,到底哪句该删、哪句该改。(官方全文翻译放文末 ,关注不迷路。)
先给结论,三个最反直觉的变化:
第一, 6.2-Sol Medium 才是 90% 人日常干活的正确选择,大多数人使用 GPT-6.2 的真实感受:Sol 快又顶,Astra 慢得让人心累
别一上来就开 Astra 满血推理——官方发布视频里,OpenAI 员工自己日常都用 Sol Ultrafast。
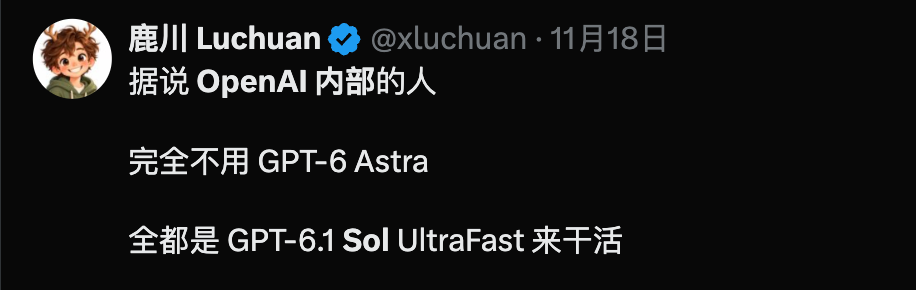
第二,6.2"干一半就停"不是懒,是变谨慎了:指令有一点模糊,它就列计划等你拍板。
第三,你以前写死的"请简洁回答",现在反而帮倒忙:6.2 默认文风已经够精简,再压就食之无味。
笔者就栽在第三条——项目提示词写了句“代码修改遵循最小必要原则”,结果它把关键动作也一起省了。
看到这你可能会问:那我把提示词写得更细、步骤拆得更碎,不就行了?
我替你试过了——不行。你越像保姆一样一步步教,它越容易在每一步停下来等你确认;你越想控制细节,它越容易在"最小必要"里把该做的也省掉。
要让 6.2 真正顺手,思路得反过来:放权细节,卡死标准。
就像在公司管理员工,能力差的员工,你要手把手教,能力强的员工,你只需要给出验收标准,然后放手让他去做。扣得太细,员工累你也累。
核心干货:3 条,每条 = 痛点 → 对比 → 可复用模板
技巧一:用"验收标准"代替微观管理(治"干一半就停")
- 痛点:一步步教它写代码、调样式,它反而每步都停下来确认。
- 错误做法:“帮我画一个设置图标,线条 2px,圆角 4px,不要太多阴影……”
- 正确做法:“帮我画一个设置图标,需要保证在 24 像素工具栏里依然清晰可辨。”
- 可复用模板:
目标 + "你验收时会看什么" + 允许合理假设的边界 - 原理:把验收标准给死,模型自己会参考项目风格权衡细节,不再推一步动一步。
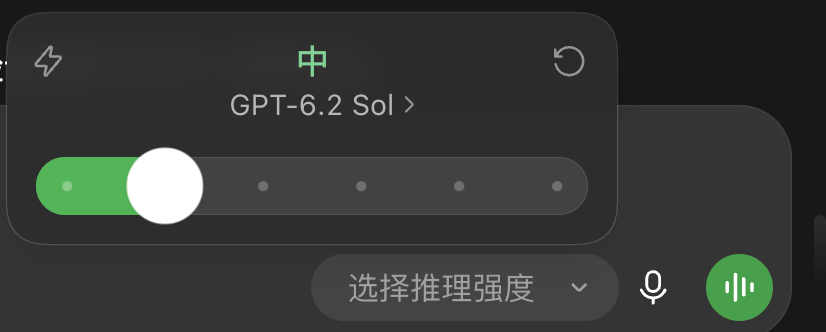
技巧二:推理强度跟着任务深度调(治"无脑拉满算力")
- 痛点:一上来开满血推理,慢且容易过度发散。
- 对照表:
- Medium(默认起点):快速调研、常规编码、初步排查
- High:跨系统/跨文件追踪单一故障根因
- Extra High:多原因交织时开启,且必须写明"做到哪步算彻底完成"
- 可复用模板:
先用 Medium 跑通基准线,卡壳再往上加;开 Extra High 必附完成标准
技巧三:能拆就授权子代理 + 视觉走"参考图→渲染→实尺寸验收"闭环
- 痛点:多模块复杂任务串行做,慢且容易乱;前端/3D 光靠文字描述,出图不可控。
- 做法:
- 指令里加一句"需要时使用子代理",模型自己拆解分工;常跑就写进 Skill 或 AGENTS.md。
- 视觉任务:先给参考图(或让它调 GPT Image 生成)→ 生成资产实际渲染 → 按终端用户实际尺寸验收,交互组件让它自己点一遍。
- 可复用模板:
多模块任务 + "需要时使用子代理";视觉任务 + "按实际显示尺寸检查"
另外,项目级 AGENTS.md 要写薄——只留模型从代码、测试、文档里看不出来的"硬规矩",日常决策全交还给它。
写在最后
一句话速查口诀:选好模型(Sol + Medium)→ 不约束输出(删掉"请简洁")→ 抓大放小(写清验收标准和假设边界)。
其实,每一个新大模型都有自己的性格与习惯,就像团队里来了一位能力极强但脾气全新的搭档,彼此之间必然有一个磨合期。
刚开始觉得它“叫不动”、“爱停顿”,往往是因为我们还在用旧习惯和它沟通。 只要对照官方指南,把手边的提示词和 AGENTS.md 稍作调整,理顺这套新的协作默契,才能真正把 GPT-6.2 的最大威力发挥出来。
你这两天上手 GPT-6.2 了吗?在使用 Codex 或调用 API 时有没有遇到“干一半停下来”或者其他奇葩情况?欢迎在评论区留言交流你的实测体验和调教技巧!。
附件1:《在 Codex 中使用 GPT-6.2:提示词最佳实践》。
原文:https://learn.chatgpt.com/guides/prompting-gpt-6-2-astra
合理选择推理强度、使用子代理并行处理任务,以及利用 GPT-6.2 系列模型不断优化视觉设计成果。
与 GPT-6 Astra 相比,GPT-6.2 Astra 通常能够在第一次尝试时,就生成更接近用户预期、可以直接投入使用的成果。它编写的代码更易于阅读和审查,文字表达也更加简洁直接。在视觉设计方面,它的表现同样更加出色。
例如,在制作演示文稿时,它能够通过合理的布局,让读者一眼注意到最重要的对比信息;在创建 3D 场景时,它能够通过材质、纹理和灯光等细节,让作品更加生动、更具特色。
这些提示词技巧适用于整个 GPT-6.2 模型家族,包括 GPT-6.2 Astra 和 GPT-6.2 Sol。
向 Codex 描述任务时,可以像向一位熟悉项目的同事交代工作一样,直接说明你的需求。同时,还应明确告诉 Codex:你最终会按照什么标准来检查和验收它的工作。
例如,如果你需要设计一个图标,并且要求它在 24 像素的工具栏中仍然清晰可辨,就应该明确提出这一要求。
Codex 可以参考项目中已有图标的风格,自行判断应该保留哪些细节,以及如何确保图标缩小后仍然容易识别。
一、根据任务选择合适的推理强度
更高的推理强度 (Reasoning effort),可以帮助模型在处理长时间运行的复杂任务时坚持执行,直到完成最后的检查。
即使你最终需要的答案只有几行文字,背后也可能需要大量的调查和验证。
因此,向 Codex 布置任务时,应当明确说明:
- 什么情况下才算真正完成任务。
- 哪些环节需要全面、彻底地检查,不能遗漏。
例如,如果团队需要一个决策建议,Codex 就不能仅仅找到一个看起来合理的解释便结束工作。它可能需要沿着最有希望的调查方向继续深入,并将结果与其他可能的解释进行比较和验证。
应该根据任务所需的调查深度,选择合适的推理强度 (Reasoning effort)。
- Medium (中等):适合快速调查、初步分析,以及不需要深入追查的问题。
- High (高):适合需要深入调查的任务。即使只有一个疑似原因,如果需要跨越多个系统进行追踪,也值得使用 High。
- Extra High (超高):当多个问题可能相互影响,而且调查必须全面分析每一种潜在原因及其关联时,可以考虑使用 Extra High。
二、使用子代理并行处理任务
当一个任务包含多个可以独立推进的部分时,应明确告诉 Codex:根据需要使用子代理 (Subagents)。
这样就相当于授权 Codex 自行判断:
- 是否值得使用多个子代理并行工作。
- 哪些任务适合交给子代理。
- 应该如何拆分和分配任务。
详细说明可参考官方文档:触发子代理工作流 (Triggering subagent workflows)。
如果某一类工作经常重复出现,可以把“根据需要使用子代理”这条指令写入相关的 Skill (技能) 或 AGENTS.md 文件,并明确说明它在什么情况下适用。
例如,对于一个专门用于研究分析的 Skill,可以规定:当用户提出多个相互独立的研究问题时,Codex 可以使用子代理并行开展调查。
对于 Ultra 模式,Codex 则会自主判断何时需要引入子代理,不必每次都由用户明确要求。
不过,Ultra 更适合那些特别复杂、规模较大,而且能够清晰拆分为多个独立部分的任务。
例如,一个开放式研究项目可能包含多个问题,每个问题都需要深入调查。这时可以让不同子代理分别负责一个研究方向。
每个子代理都可以拥有独立的工作上下文,专注于自己负责的问题。
三、提供视觉参考,让 Codex 持续迭代设计
当你对作品的视觉效果有明确要求时,一张参考图片往往比大段文字描述更加直观。
参考图片可以帮助 Codex 理解:
- 各种图形和元素应该如何组合。
- 哪些颜色需要突出。
- 画面的视觉重点应该放在哪里。
- 用户第一眼应该注意到什么。
你可以直接提供设计软件中的参考图片,也可以让 Codex 使用 GPT Image 生成一张参考图。
当参考图准确体现你想要的视觉风格后,就可以要求 Codex:
- 根据参考图制作实际设计成果。
- 渲染并展示最终效果。
- 将渲染结果与参考图进行比较。
- 根据差异继续修改和完善。
要让 Codex 按照用户最终实际看到的尺寸检查设计效果。
因为有些细节在大尺寸图片中看起来非常精致,但缩小到真实使用尺寸后,可能就完全看不清了。
例如,一个图标在 1024 像素的预览图中效果很好,但真正放到 24 像素的工具栏里时,原本精细的线条和装饰可能全部消失。
如果设计成果具有交互功能,还应该要求 Codex 实际测试这些交互操作,确认它们能按预期工作。
SVG & 3D Design 插件 内置了相关 Skill,可以指导 Codex 按照上述流程,创建和优化可编辑的插画与 3D 模型。
四、保持 AGENTS.md 精简
AGENTS.md 应主要用于记录那些 Codex 无法直接从代码、测试或项目文档中推断出来的项目要求和约定。
例如:
- 项目必须遵守的特殊规范。
- 已有代码中无法直接体现的业务约束。
- 项目明确依赖的特定工作流程。
如果项目必须按照某种固定流程执行任务,就应该把这套流程写进去。
但对于日常工作中常见的执行方式和一般性决策,应该让 Codex 自行判断,而不是把每一个操作步骤都写成死板的规则。
换句话说,AGENTS.md 应该重点说明项目有哪些必须遵守的要求,而不是事无巨细地规定 Codex 每一步应该怎么做。
在 Codex Cloud 中,每个任务都有一台独立的虚拟机。
如果你希望 Codex 工作时,自己仍然能够正常使用电脑,可以在个人配置文件 ~/.codex/AGENTS.md 中加入相关要求,引导 Codex 优先使用不会干扰你当前操作的工具。
例如,如果 Codex 只是需要快速查找一封邮件,可以鼓励它使用已经接入的邮件连接器,而不是通过会抢占当前应用焦点的方式操作邮件软件。
这样,你就可以继续使用电脑处理其他工作。
当多个代理共享同一台计算机时,还需要注意计算资源的分配。
应该要求每个代理根据实际需要,合理控制同时运行的构建和测试任务数量。
在条件允许的情况下,为其他代理保留足够的 CPU 和内存资源,避免多个代理同时占满机器,影响整体工作效率。
但这并不意味着必须始终限制资源使用。
如果某个任务确实需要大量计算资源,也应该允许它在必要时充分利用整台计算机的性能。
最后,在完成任务并准备结束工作时,应要求每个代理:
- 停止由自己启动的后台任务。
- 清理已经不再需要的临时文件。
这样既能避免后台任务持续占用资源,也能保持工作环境整洁,为后续任务做好准备。
附件2:《Using GPT-6.2(API 开发者迁移指南)》
原文:https://developers.openai.com/api/docs/guides/latest-model?model=gpt-6.2-astra&utm_source=chatgpt.com
翻译:
对于要求最严苛的任务,使用 GPT-6.2 Astra;如果希望以较低成本完成复杂工作,可以使用 GPT-6.2 Sol。
新增变化
前缀编辑 (Prefix edits):从 GPT-6.2 开始,如果在对话中途修改此前的对话历史 (即前缀编辑)、进行某些模型切换 (包括降级),或更改最终用户或组织,Responses API 就会丢弃此前的推理项 (Reasoning items)。失去这些推理信息后,模型的回答质量可能下降,也可能需要消耗更多 Token 来重新完成之前做过的工作。请检查应用集成中是否存在修改早期
developer消息或工具调用等操作。为了保留推理信息,并让此前的输入继续符合提示词缓存条件,在两次响应之间更改设置时,应尽量保持前缀不变。Responses API 中
instructions字段的变化:从 GPT-6.2 开始,模型会把 Responses API 顶层的instructions放在input后面处理。如果希望可重复使用的指令能够命中提示词缓存,应将这些指令放在input的第一条developer消息中。顶层instructions则适合用于仅对当前请求生效的开发者指令。详见前缀匹配的工作原理。后台模式 (Background mode,公开测试版):对于运行时间较长的 Responses API 请求,可以在后台模式中使用折扣完成时间窗口,作为 Flex 处理模式的替代方案。后台请求支持在 Standard 处理模式下选择两小时或八小时的完成窗口。GPT-6.2 Astra 和 Sol 均不支持 Flex 处理模式 (
service_tier: flex)。
提示词最佳实践
以下提示词可作为 GPT-6.2 整个模型家族的使用起点。这些示例针对 OpenAI 在使用 GPT-6.2 Astra 和 Sol 时观察到的模型行为。如果你在自己的应用中遇到类似情况,可以尝试对应章节的提示词。
GPT-6.2 Astra 的行为特点
- 写作风格:模型默认倾向于更加简洁、直接的表达。升级模型时,应重新审视系统提示词中诸如“保持简洁”的要求。
- 任务完成:当用户意图不够明确时,模型可能只提出下一步建议,然后等待确认。对于较长的任务,应允许模型做出合理假设并继续工作。
- 代码风格:与前代模型相比,模型倾向于编写效率更高、质量更好的代码。应明确告诉它项目中需要遵循哪些代码约定。
- 前端设计:如果界面需要特定的视觉风格,应明确指定图片素材及字体排版要求。
写作风格
GPT-6.2 Astra 默认比早期模型更加简洁、直接。可以根据应用场景调整它的语气,让它像专业同事一样交流,或表现得更口语化。
如果希望模型在日常工作中充当协作者和思考伙伴,可以使用以下提示词:
写作时,采用与用户及参考资料一致的术语。当技术细节和专业术语能让解释更加准确时,应予以保留和使用。尽量使用主动语态,把紧密相关的信息放在一起。先交代关键要点,避免引用那些读者必须读到后文才能理解的内容。提供足够的上下文,让用户能够理解你的分析思路。
当模型代你撰写文档、邮件、消息或对外发布的文章时,应让它根据目标读者调整表达方式。
当你代表用户撰写将发送给外部读者的消息或其他材料时,应考虑最终由谁阅读,并据此调整内容。目标读者很可能不具备与用户相同的背景信息,因此需要提供必要的背景或推理说明,确保他们能够理解内容。

审阅或修改已有内容时,应保留作者原有的内容和措辞,并认真遵循用户对修改范围及方式的具体要求。
执行较长任务时,模型有时会把自身推理过程或其他代理使用的简写带入最终答案。应提醒它写出独立、完整的回答,让没有读过进度更新的人也能理解。
将最终答案视为用户第一次看到你的工作成果,而不是此前中间说明的延续。最终答案必须始终完整、独立;用户不应该需要阅读之前的进度更新才能理解,因为这些更新在展示最终答案时会被折叠。

面向目标读者重新撰写最终答案以及其他所有供人阅读的材料。不要复制或过度贴近自己的推理过程,也不要沿用其中的写作风格。不要把推理、工具调用、发给子代理或自动化任务的指令中的临时简写、术语或缩略语直接带入最终内容。
任务完成
对于无需持续监督就能推进的工作,应明确告诉模型需要交付什么结果,以及哪些决策必须由用户本人做出。
如果任务尚未完成,或者在当前授权范围内仍有可以执行的下一步,就不要为了结束当前轮次而停下来。应继续采取任务范围内的行动,推进用户的请求。

如果你准备给出的最终回复只是建议下一步行动、提出计划、要求用户做出常规决策、说明如何执行任务,或以类似方式把工作交回用户手中,那么应先自行采取这些行动,继续推进用户要求的工作。确保你有权这样做,并向用户说明所做的假设或决定。

只有在任务范围发生重大变化、遇到实际阻碍、存在必须由用户决定的问题,或者即将执行不可逆或具有破坏性的操作时,才应停下来请求澄清。
要求模型验证自己是否完成了全部工作。对于复杂或耗时较长的任务,提高推理强度可能有助于模型坚持完成最后的检查。使用 Responses API 时,可以通过 reasoning.effort 设置推理强度。详见推理强度。
优先采取行动,并坚持工作,直到完成用户提出的任务。如果任务还没有完成,或者仍有在授权范围内可以执行的下一步,就不要提前结束当前轮次,而应继续推进。

确保已经覆盖用户请求的每一个部分,并持续工作,直到交付的结果全面满足用户目标。如果任务需要长时间投入,就应完成所有必要的工作,直到预期成果完全实现。

在行动不会明显造成破坏或不可逆后果的前提下,自主推进用户的目标,例如创建相互隔离的工作树 (Worktree) 或检出工作副本、解决合并冲突、创建草稿拉取请求 (Draft PR) 等。结束当前轮次或宣布工作完成之前,检查成果是否完全符合用户要求。如果还有未完成的步骤,或任何部分尚未验证,就继续完成和验证,而不是提前停止。
当某些细节不够明确时,可以允许模型做出合理假设并继续执行。
在任务范围内,为推进工作做出合理且可撤销的假设;如果说明这些假设有助于推进任务,就向用户说明。不要反复怀疑自己的判断,不要只描述自己能够做什么就停下来,不要只提出愿意执行工作,也不要给出不完整的结果,除非确实已经无法继续推进。
如果应用中有 request_user_input_async 之类的异步工具,GPT-6.2 可以在询问用户的同时,继续完成不依赖该回答的工作。参见添加异步提问工具。
代码风格
应向模型交代代码库的约定,以及现有调用方依赖的行为。例如,明确什么时候复用已有逻辑、修改范围应该多大,以及什么时候需要针对现有测试未覆盖的行为新增测试。
最重要的是,全面而细致地编写高质量、正确的代码,完整满足用户的任务要求。代码应易于阅读,并且要验证实际运行结果符合用户预期。编写代码时,请遵循以下原则:

(a) 能复用用户代码仓库中现有逻辑时,就优先复用。只要能够保证正确性,应沿用代码库中的类、方法、数据表示方式和 API。合并或删除代码之前,除非任务本身要求改变现有行为,否则必须保留已有调用方所依赖的行为。

(b) 除非用户明确要求、项目规范要求,或必须通过新测试捕获现有测试无法发现的特定回归问题,否则不必新增测试。

(c) 确保代码方便人类阅读。不要把减少代码行数、缩短变量名、压缩格式或堆砌单行表达式当作简洁的替代品。注释和变量名都应清楚易懂。如果极端精简的表达式把大量分支、条件或隐藏假设塞进一行,也属于过度复杂的代码。

(d) 避免不必要的间接层和抽象。辅助函数、工具函数和类抽象,即使没有增加分支,也可能提高代码的理解难度。
前端设计
如果应用需要某种特定的视觉风格,应在提示词中描述清楚。明确指定图片的类型、排版要求,以及必要时使用的具体字体。界面文案应聚焦于用户真正需要知道或执行的事情。
生成带有前端用户界面的网页或应用时,请遵循以下要求:

- 选择视觉素材时,一般优先使用符合项目风格的 ImageGen 写实图像或图片搜索结果。只有在用户明确要求时才使用 SVG。
- 仅在文字元素能够提供用户需要的信息、帮助用户导航或执行操作,或者满足明确内容要求时,才将其加入界面。删除装饰性编号、填充性的徽章、重复标题,以及仅仅重述周围界面内容的解释性文字,同时保留必要的标签、操作说明和状态反馈。
对于视觉设计工作,可以提供设计软件中的参考图,或者让 GPT-6.2 使用图像生成工具,通过 GPT Image 创建参考图。参考图可以补足那些难以用语言描述的细节。当模型掌握你想要的视觉效果后,再要求它制作素材、渲染结果,并根据参考图持续调整完善。
迁移快速入门
如果要借助编程智能体将 API 应用迁移至 GPT-6.2 Astra,可以使用 OpenAI Docs skill。
更新 API 和模型参数
将 model 设为 gpt-6.2-astra 或 gpt-6.2-sol,然后检查以下设置:
推理强度 (Reasoning effort):新接入模型时,建议先使用
medium。如果目前使用none或minimal,请改为low。在 Responses API 中通过reasoning.effort设置,在 Chat Completions 中通过reasoning_effort设置。工具调用 (Tool calling):应使用 Responses API。GPT-6.2 Astra 和 GPT-6.2 Sol 虽然也支持 Chat Completions,但使用工具调用必须通过 Responses API。
不支持的参数:迁移 Chat Completions 请求时,省略
temperature、top_p、logprobs和top_logprobs。对于 Responses 请求,省略temperature、top_p和top_logprobs,并从include中移除message.output_text.logprobs。提示词缓存 (Prompt caching):将稳定、不经常变化的指令从顶层
instructions参数移到input开头的developer消息中,以便这些指令能够命中缓存。从 GPT-5.5 或更早版本迁移时,将prompt_cache_retention替换为prompt_cache_options.ttl,并将其设为"30m"。还应阅读提示词缓存的变化,了解缓存边界和缓存写入如何计费。零数据保留 (Zero Data Retention,ZDR):对于已获批准的组织,GPT-6.2 Astra 和 Sol 在符合条件的端点与功能上支持 ZDR。启用后,Responses API 会把
store视为false。处理多轮任务时,需要按原顺序将之前的输出项重新传入,包括加密的推理项。具体适用条件和端点行为请参阅零数据保留。服务等级与区域 (Service tiers and regions):两个模型都支持美国和欧盟的数据驻留,并支持 Standard、Fast 和 Batch 处理模式。Ultrafast 只支持美国的数据驻留。详见数据驻留与定价。
提示词 (Prompting):参见上文提示词最佳实践中的建议。